KI
Abo oder API bei KI – eine Rechnung für 25 Mitarbeitende
KI-Kosten bei OpenAI, Anthropic und Google, durchgerechnet für 25 Mitarbeitende. Team-Seats sind derzeit meist günstiger, für Agenten bleibt nur die API.
11.11.2026
Dieselbe Code-Änderung, immer wieder von Claude Code geprüft: Auf „medium“ war nach zwei Fixes Ruhe, auf „high“ kamen 71 Befunde und neue Fehler.
Wer mit KI Code reviewen lässt, kennt das Gefühl: Die Liste ist nie leer. Egal wie oft man nachbessert, die nächste Runde bringt wieder fünf, acht, zehn Punkte. Irgendwann fragt man sich, ob der Code wirklich so schlecht ist oder ob das Werkzeug einfach immer etwas findet.
Genau das wollte ich wissen. Ich bin Softwareentwickler bei 3HillsIT und nutze Claude Code täglich, auch für Reviews. Was als Beobachtung in einem großen Pull Request begann, wurde zu einem kleinen Experiment. Die Ergebnisse habe ich zuerst auf LinkedIn geteilt, hier fasse ich beides zusammen – mit dem, was ich daraus für unsere Arbeit mitnehme.
Ausgangspunkt war ein großer Pull Request mit 137 Dateien. Claude hatte ihn bereits dreimal reviewt, und ich hatte alle Befunde eingearbeitet. Dann habe ich eine vierte Runde gestartet. Meine Vermutung vorab: Die KI findet trotzdem etwas.
Sie fand 14 Punkte, sechs davon als „Wichtig“ eingestuft. Ich habe nachgefragt: „Was ist tatsächlich wichtig?“ Die Antwort: genau einer. Der Rest war Feinschliff und Randfälle.
Das Spannendste daran war dieser eine echte Fehler. Ihn hatte ein Fix aus einer früheren Review-Runde eingeführt. Das Review hatte also ein Problem gefunden, das ein früheres Review erst verursacht hatte.
Zwei Dinge habe ich daraus mitgenommen:
Ein einzelner Pull Request ist eine Anekdote. Also habe ich es genauer wissen wollen und einen Versuch aufgesetzt, der sich wiederholen lässt:
/code-review.Das ist bewusst eine strenge Versuchsanordnung. Im Alltag würde niemand jeden Hinweis ungeprüft übernehmen. Aber genau so sieht man, wohin ein Review-Prozess läuft, wenn man der KI das letzte Wort lässt.
Dieselbe Änderung, dasselbe Modell, nur eine andere Stufe – und zwei völlig verschiedene Verläufe.
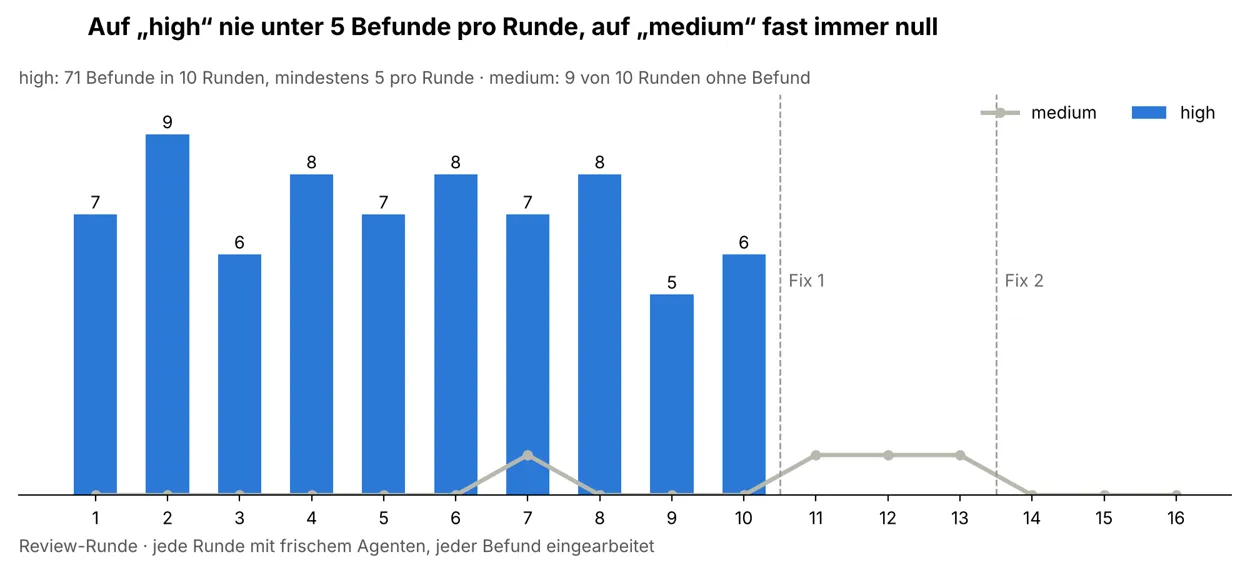
Auf „medium“ blieben 9 von 10 Runden ohne Befund. Nach zwei Fixes war Ruhe. Am Ende umfasste die Änderung 3 Dateien und +242 Zeilen.
Auf „high“ kam keine Runde mit weniger als 5 Befunden aus. Insgesamt waren es 71 Befunde in 10 Runden. Aus 2 Dateien wurden 20, aus 192 Zeilen 710. Der Code wurde mit jeder Runde größer, aber nicht spürbar besser. Warum, zeigt der Blick in die Befunde.
Auf „high“ hat das Review den Code nicht besser gemacht, sondern im Kreis geschickt. Beim Durchgehen der Befunde sind mir vier Muster aufgefallen:
Der vierte Punkt ist der teuerste. Er deckt sich mit der Beobachtung aus dem großen Pull Request: Der einzige wirklich wichtige Befund war dort ebenfalls ein Fehler, den ein früherer Review-Fix eingeführt hatte.
Mehr Gründlichkeit heißt beim KI-Review nicht mehr Qualität. Ab einem gewissen Punkt erzeugt das Review die Probleme, die es danach meldet.
KI-Reviews sind nützlich, solange ein Mensch entscheidet, was davon umgesetzt wird. Für meine eigene Arbeit und für Teams, die KI im Review einsetzen, ziehe ich daraus fünf Regeln:
So, wie ich ihn eingesetzt habe, ist der eingebaute Review-Skill auf „high“ für mich nicht zu gebrauchen. Deshalb arbeite ich an einem eigenen Skill, der genau diese Probleme adressiert: mit „nichts gefunden“ als gültigem Ergebnis, einer ehrlichen Einstufung der Befunde und Regeln dafür, wann ein Review fertig ist.
Kostenlos, unverbindlich, 30 Minuten. Wir hören zu, bevor wir etwas vorschlagen.
Dieser Beitrag ist mit KI-Unterstützung entstanden — Entwurf mit KI, Freigabe durch unser Team. Wir arbeiten selbst so, wie wir es unseren Kund:innen empfehlen.
KI-Kosten bei OpenAI, Anthropic und Google, durchgerechnet für 25 Mitarbeitende. Team-Seats sind derzeit meist günstiger, für Agenten bleibt nur die API.
Mehr als die Hälfte der Unternehmen nutzt KI, kaum eines schöpft sie aus. Fünf Hürden aus der Praxis und warum die meisten an derselben Stelle liegen.
Astro statt WordPress, kein Redaktionssystem außer im Blog und warum bei uns das Marketing die Seitentexte selbst ändert.