
Chat und Modelle
Jedes Sprachmodell an einem Ort, unter Ihren Regeln.
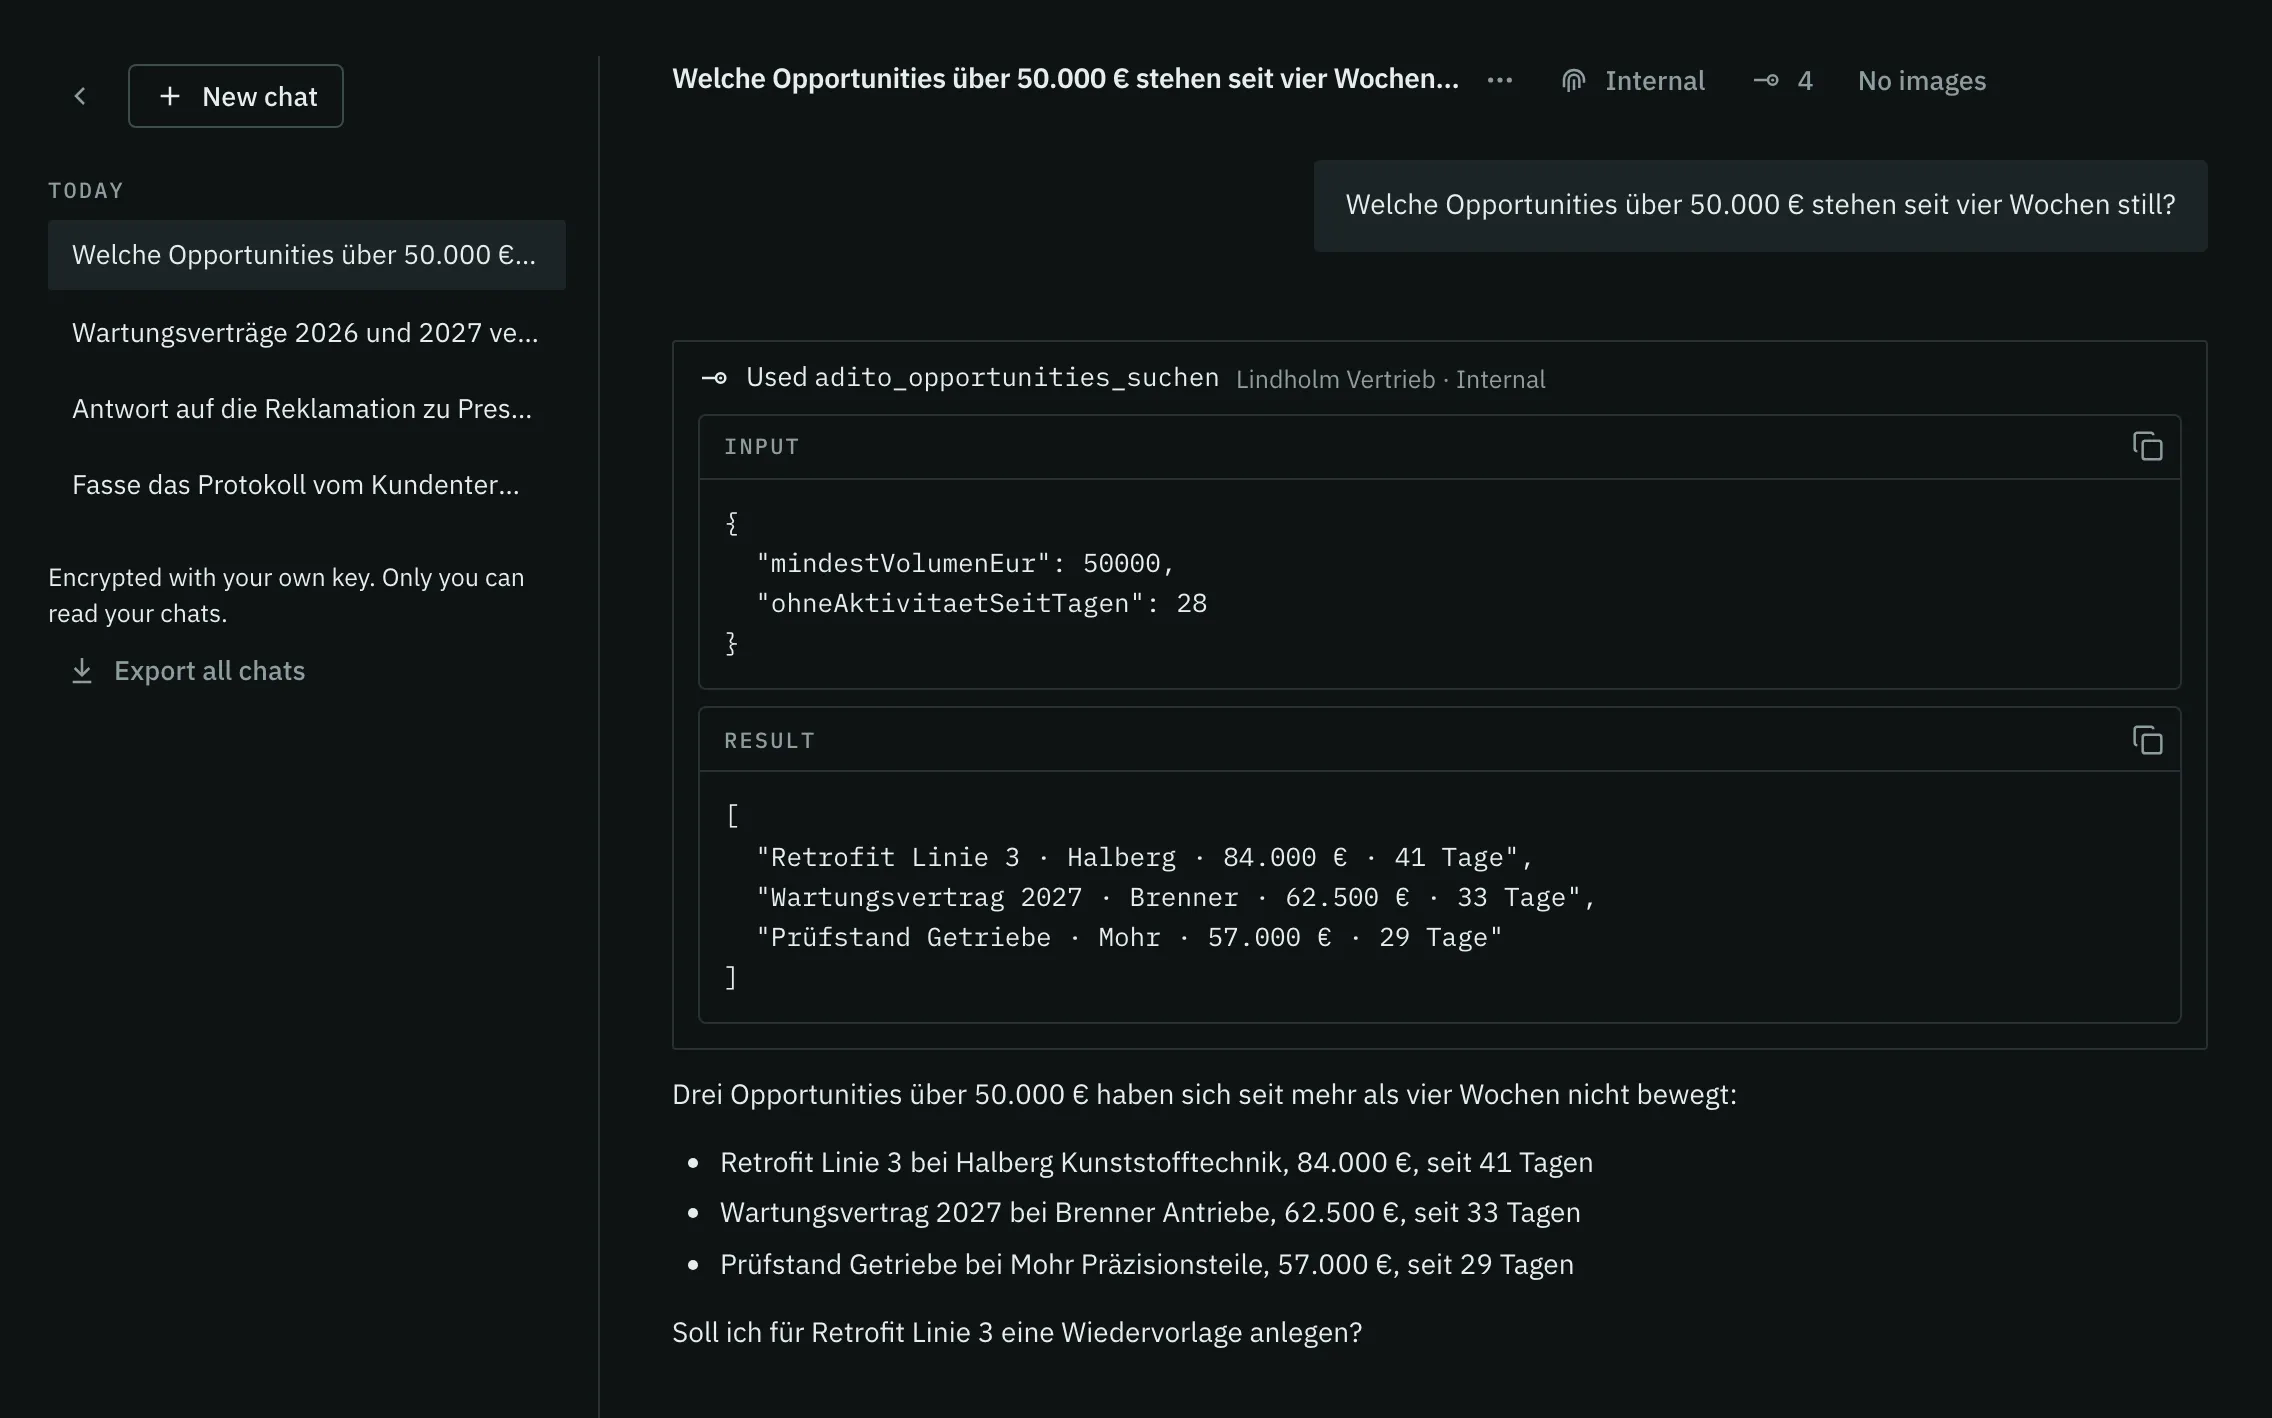
Im Chat von atrium, der KI-Plattform für Unternehmen, arbeiten Sie mit den Sprachmodellen, die Ihr Unternehmen freigibt, etwa von OpenAI oder Anthropic. Daten aus CRM, Tickets und Dokumenten holt das Modell bei Bedarf dazu. Wer welches Modell nutzt, wie viel und welche Daten es sehen darf, legen Admins fest.
Multi-LLM Chat
Ein Chat, der nachschlägt und handelt
Sie wählen pro Chat ein Modell, wechseln es im Gespräch und hängen Dateien an. Braucht eine Frage Daten, etwa aus dem CRM, ruft das Modell die Tools auf, die Ihrem Team in atrium zur Verfügung stehen. Dabei gelten dieselben Regeln wie für Claude oder Copilot, wenn sie über atrium zugreifen.
- Modelle von OpenAI, Anthropic, Azure OpenAI, OpenRouter oder Ihrem eigenen Server
- Jeder Tool-Aufruf mit Eingabe und Ergebnis in der Antwort
- Schreibende Zugriffe warten direkt im Chat auf Freigabe
Budgets
KI-Kosten, die Sie planen können
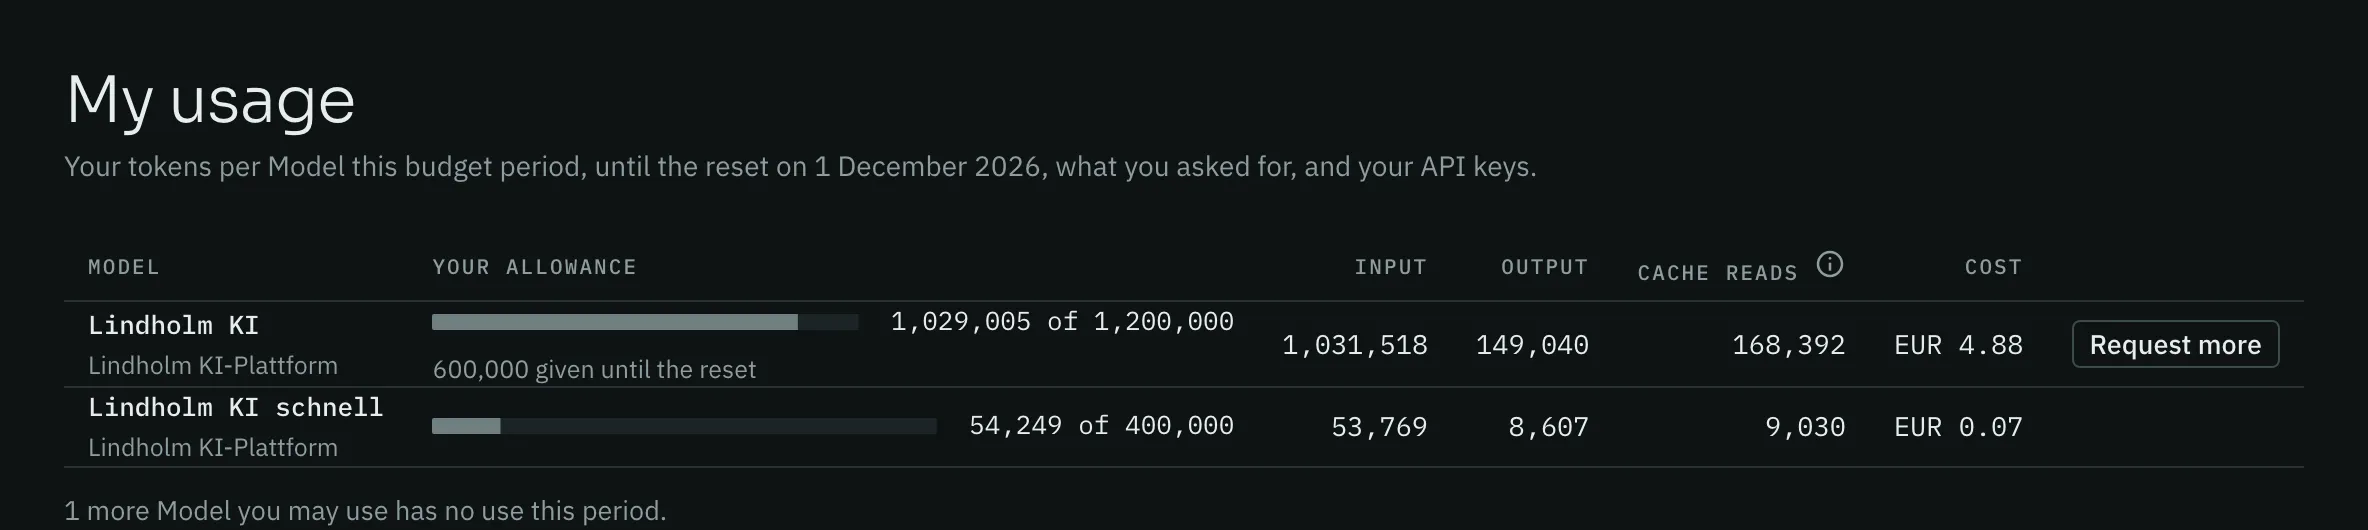
Ein Gesamtlimit pro Modell und ein Kontingent pro Person, auf Wunsch passend zum Abrechnungstag Ihres Modellanbieters. Sie sehen Ihren eigenen Verbrauch, bevor das Kontingent knapp wird.
- Warnung bei 80 % des Kontingents
- Mehr Kontingent auf Anfrage, mit Begründung und Entscheidung durch einen Admin
- Eine laufende Antwort wird zu Ende geschrieben, auch über dem Budget
Nutzung und Kosten
Was jedes Modell kostet, Tag für Tag.
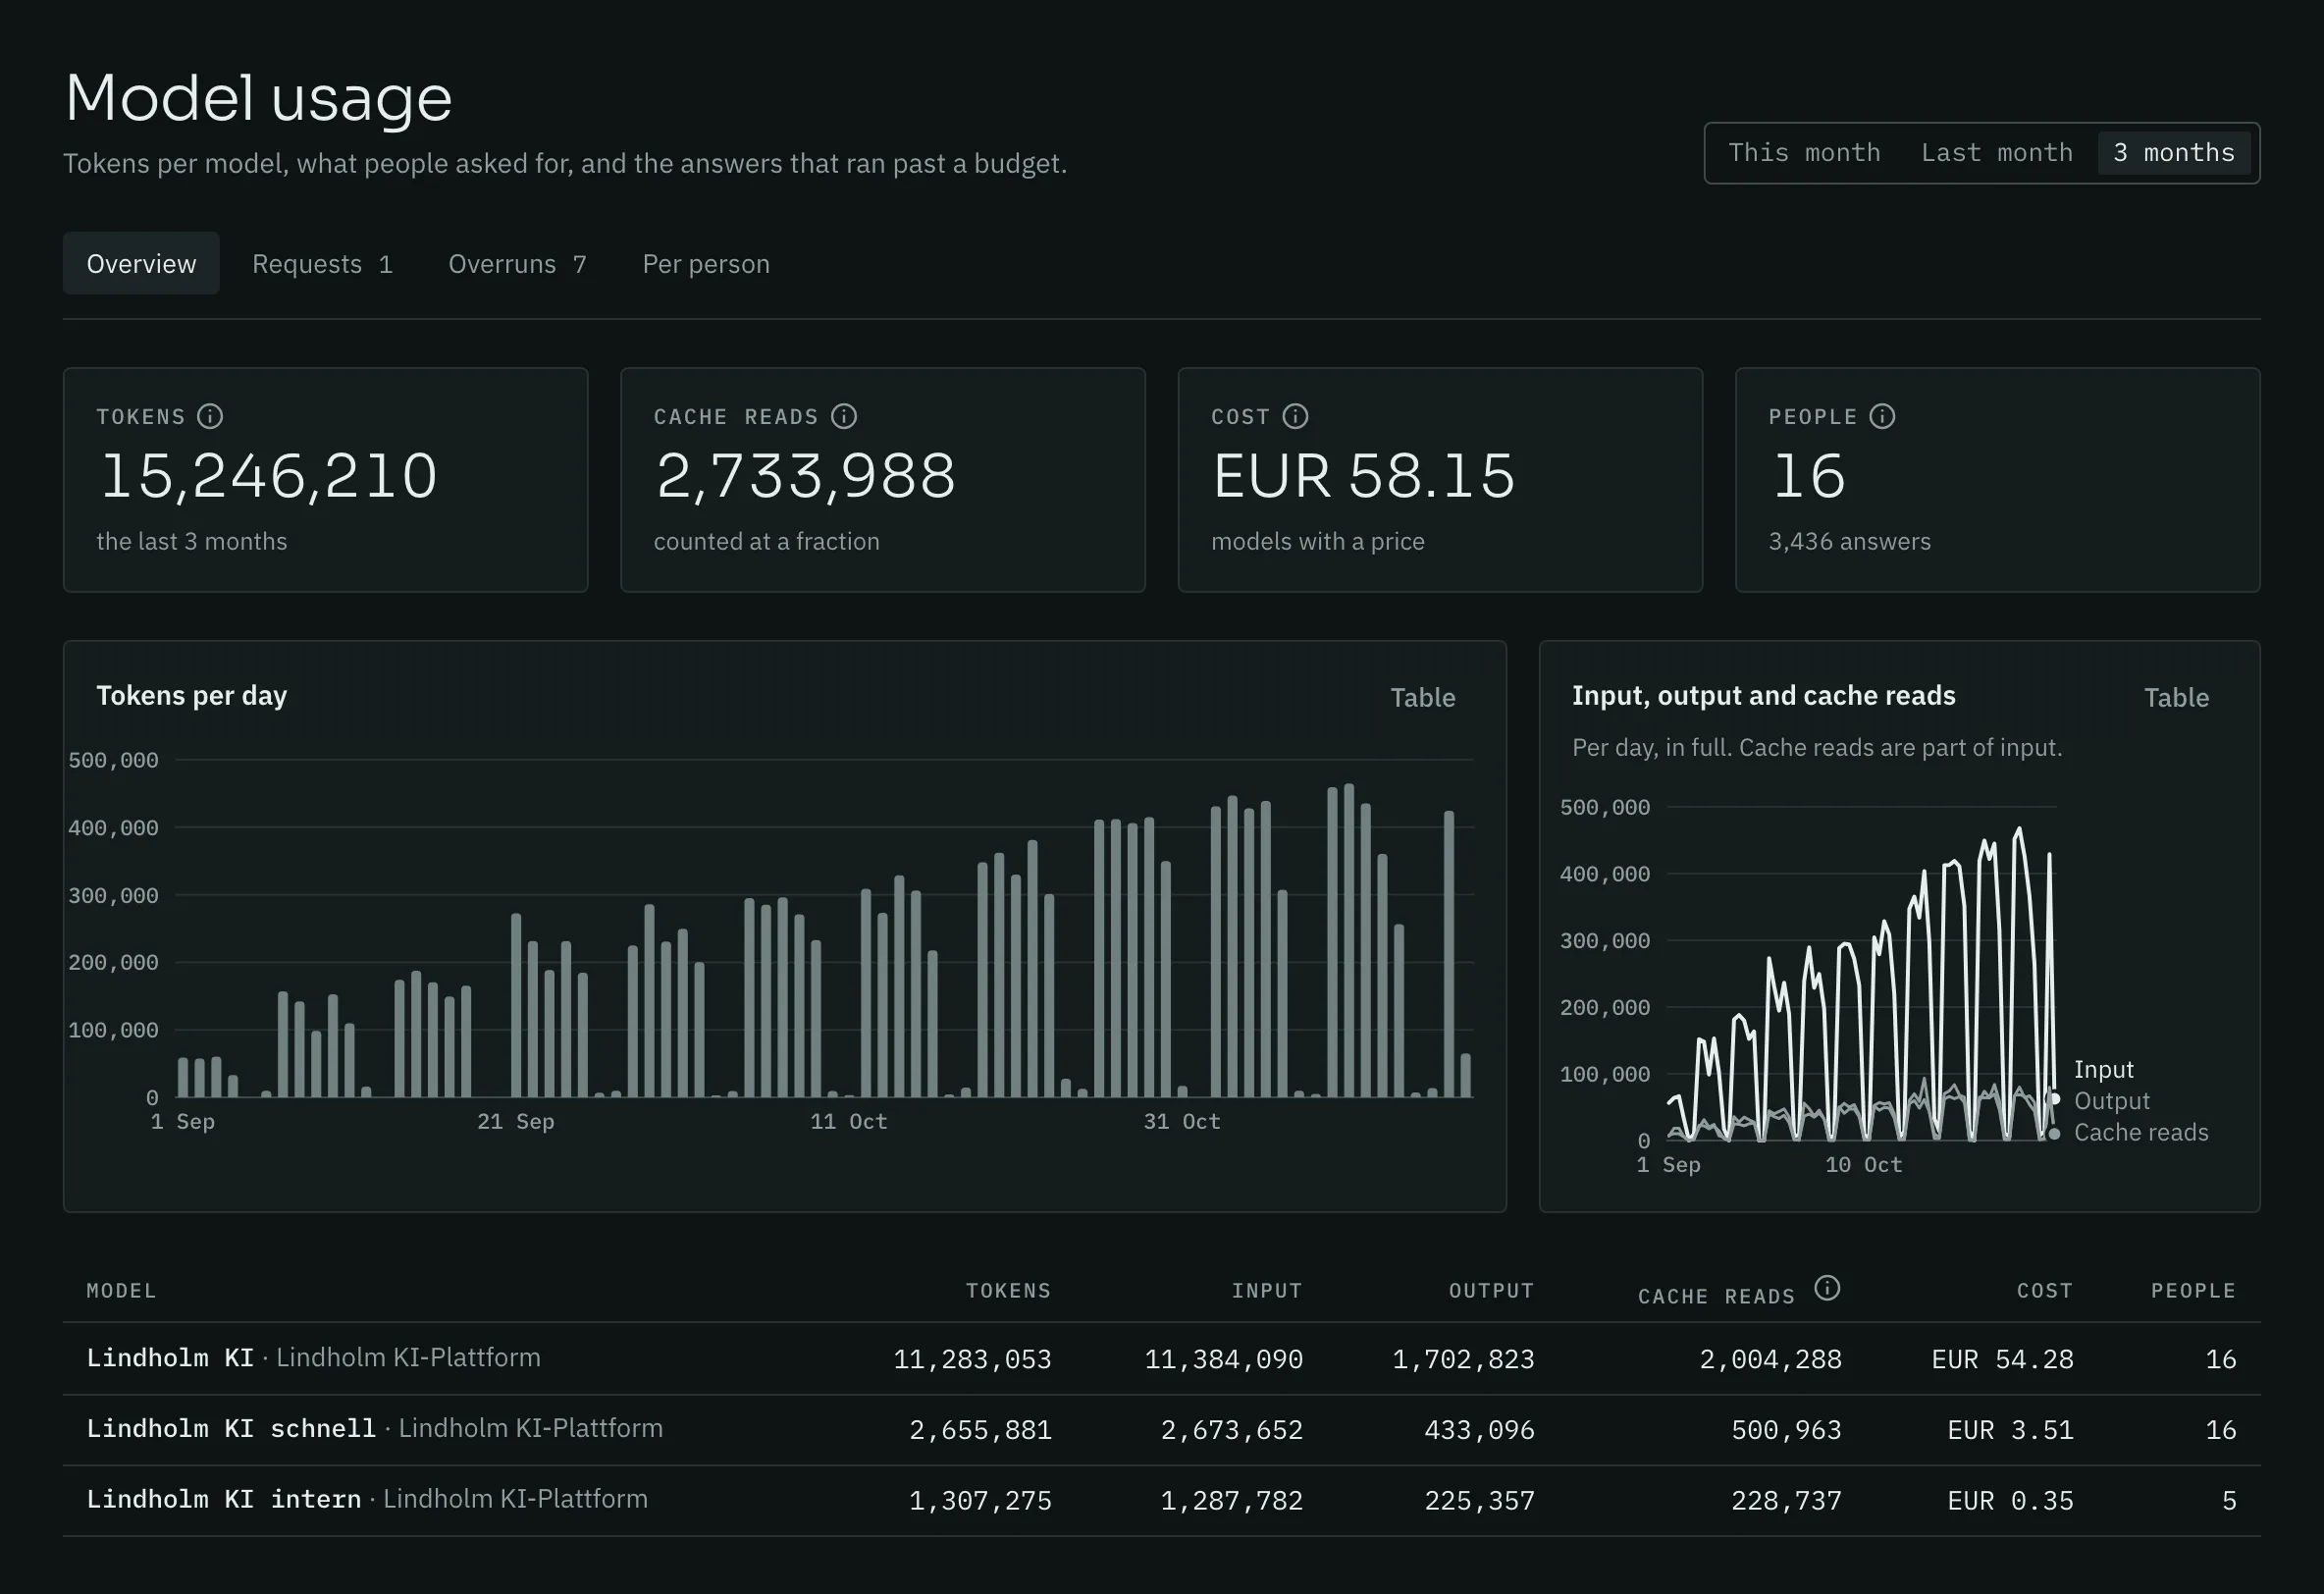
Admins sehen pro Modell Tokens, Kosten und die Zahl der Personen, für diesen Monat, den letzten oder die letzten drei. atrium rechnet mit den Preisen, die Sie hinterlegen; maßgeblich bleibt die Rechnung des Modellanbieters.
Außerdem
Zugriff, Schlüssel, Datenschutz und eigene Modelle.
Modellzugriff pro Person
Ein Modell für alle, für benannte Personen oder nur für Admins freigeben und unter einem eigenen Namen anzeigen. Jede Person sieht nur die Modelle, die sie nutzen darf.
Überschreitungen und Anfragen
Admins sehen in eigenen Reitern, wer sein Kontingent überschritten und wer mehr angefragt hat, jeweils mit Begründung und Entscheidung.
API-Schlüssel für Entwickler:innen
Sie erstellen eigene Schlüssel für Claude Code, Ihre IDE oder Skripte, bis zu 90 Tage gültig, und widerrufen sie selbst. atrium übersetzt zwischen den API-Formaten von OpenAI und Anthropic.
Private, verschlüsselte Chats
Ihre Chats sind mit einem Schlüssel verschlüsselt, der nur Ihnen gehört. Admins können sie löschen, aber nicht lesen. Auf Wunsch blendet ein Betriebsratsmodus alle Nutzungsauswertungen pro Person aus.
Datenstufen für Modelle
Jedes Modell bekommt eine höchste Datenstufe, von Öffentlich bis Streng vertraulich. Ein Chat mit vertraulichen Daten läuft nur mit Modellen weiter, die dafür freigegeben sind.
Ihr eigenes Modell
vLLM, Ollama, LM Studio oder Open WebUI in Ihrem Netz funktionieren wie ein öffentlicher Anbieter. Ein Modell ohne Budget lässt sich ohne Limit nutzen.
Weiter in atrium
Zwei weitere Bereiche von atrium.
Systeme anbinden
Ihre Systeme, erreichbar für jede KI
Claude, ChatGPT, Copilot und Ihre IDE greifen über atrium auf CRM, Tickets und Dokumente zu.
- Workspaces pro Team
- Connectors und MCP Bridges
- Knowledge Sources
Kontrolle und Betrieb
Die KI bereitet vor, ein Mensch entscheidet
Freigaben, bevor eine KI in ein System schreibt, Datenstufen, die festlegen, welches Modell sensible Daten sieht, und ein Protokoll jedes Tool-Aufrufs.
- Schreibfreigaben
- Datenstufen
- Audit-Log
Fangen wir mit Ihrem ersten KI-Anwendungsfall an.
Im Pilotgespräch klären wir, bei welcher Aufgabe die KI in Ihrem Unternehmen am meisten hilft und welche Systeme wir dafür an atrium anbinden.